Définir la granularité des observations
Une observation est identifiée par la station, l’horodatage et le système source. Une clé déterministe préserve cette distinction, sans fusionner implicitement les sources.
Ingénierie des données
Étude de cas / 03
Une granularité cohérente entre les sources.
Unifier des sources météo hétérogènes en observations analytiques traçables, avec des transformations SQL structurées et des règles de qualité explicites.
Technologies et concepts
Démonstration technique / sources sélectionnées
Dépôt privé
01 / Le contexte
Les sources météo utilisent des identifiants de station et des structures de champs différents. Pour comparer les observations, le modèle analytique doit définir une granularité stable, conserver leur provenance et préciser les exigences de qualité.
02 / Choix techniques
Une observation est identifiée par la station, l’horodatage et le système source. Une clé déterministe préserve cette distinction, sans fusionner implicitement les sources.
Des couches distinctes de données brutes, de préparation, de transformation intermédiaire et de tables analytiques normalisent deux contrats source et relient les observations aux métadonnées des stations.
Des contrôles d’unicité, de valeurs non nulles, de relations, de valeurs autorisées, de plages et de dates expriment les conditions nécessaires à l’analyse. Les doublons sont détectés plutôt que supprimés implicitement.
03 / Vue du système
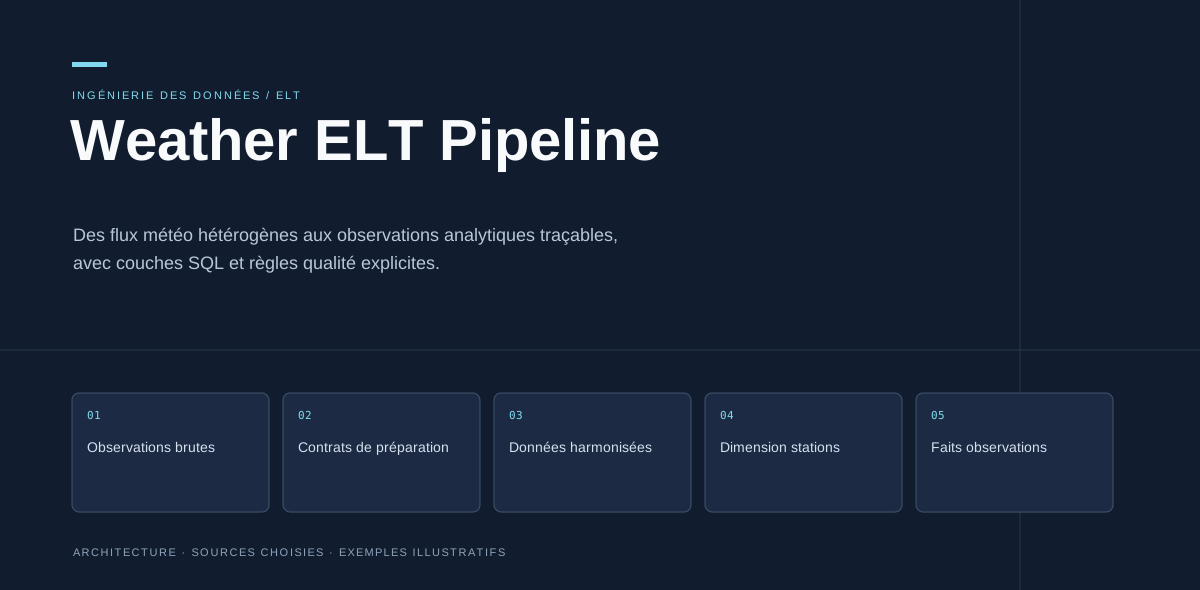
Architecture illustrative issue de la présentation du projet. Elle décrit la conception sélectionnée ; elle ne constitue ni un service déployé ni un résultat opérationnel mesuré.
Afficher le schéma en grandObservations brutes
Contrats de préparation
Données unifiées
Dimension stations
Faits d’observation
04 / Sources présentées
dbt/models/staging/dbt/models/intermediate/dbt/models/marts/dbt/macros/generic_tests/dbt/tests/docs/model-design.mddocs/data-quality.md05 / Périmètre et limites
Démonstration et présentation du code utilisant des métadonnées de stations synthétiques et des observations générées. Aucune ingestion en direct, aucun déploiement, résultat d’exécution, débit ou taux de réussite des tests n’est revendiqué. Airbyte représente le point d’entrée de l’ingestion ; les connexions et la planification opérationnelle demandent une configuration distincte. Le contrôle des six stations est propre au jeu de démonstration, et les contrôles temporels dépendent de l’instantané des données.
Le dépôt GitHub est privé. Son lien fonctionne pour les collaborateurs autorisés ; les autres visiteurs peuvent me contacter pour discuter du projet.
Étude de cas suivante / 04
La prochaine conversation