Thomas BrochardDéveloppement · Data · IA
Échangeons
Retour aux projets

Systèmes de recherche augmentée

Étude de cas / 09

Cultural Events RAG

Conserver les sources tout au long de la recherche.

Relier les questions en langage naturel aux événements culturels grâce aux métadonnées, à des réponses fondées sur les sources et à des références vérifiables.

Technologies et concepts

  • Python
  • LangChain
  • FAISS
  • Embeddings Mistral
  • Gemini / Mistral
  • Streamlit

Démonstration technique / sources sélectionnées

Dépôt privé

01 / Le contexte

Le problème à l’origine de la conception.

Les catalogues d’événements contiennent de longues descriptions, des séances répétées et des métadonnées hétérogènes. La recherche en langage naturel doit relier les questions aux événements pertinents tout en conservant dates, lieux et liens vers les sources originales.

02 / Choix techniques

Des choix rendus explicites.

Préserver les métadonnées des événements

L’ingestion et le découpage conservent l’identité des événements, les dates, les lieux et les références source aux côtés du texte. La recherche privilégie les candidats dont les dates recoupent les mois mentionnés dans les questions françaises ou anglaises.

Prévoir des solutions de repli délimitées

Une recherche lexicale prend le relais lorsque les embeddings sont indisponibles ou soumis à une limite de débit. Lorsque la génération est limitée, une liste extraite des événements présente les métadonnées retrouvées.

Séparer les signaux d’évaluation

Le rappel de la recherche et l’évaluation des réponses par rapport à une référence sont examinés séparément. L’instrumentation distingue ingestion, nettoyage, découpage, calcul des embeddings, recherche et génération.

03 / Vue du système

Suivre le cheminement.

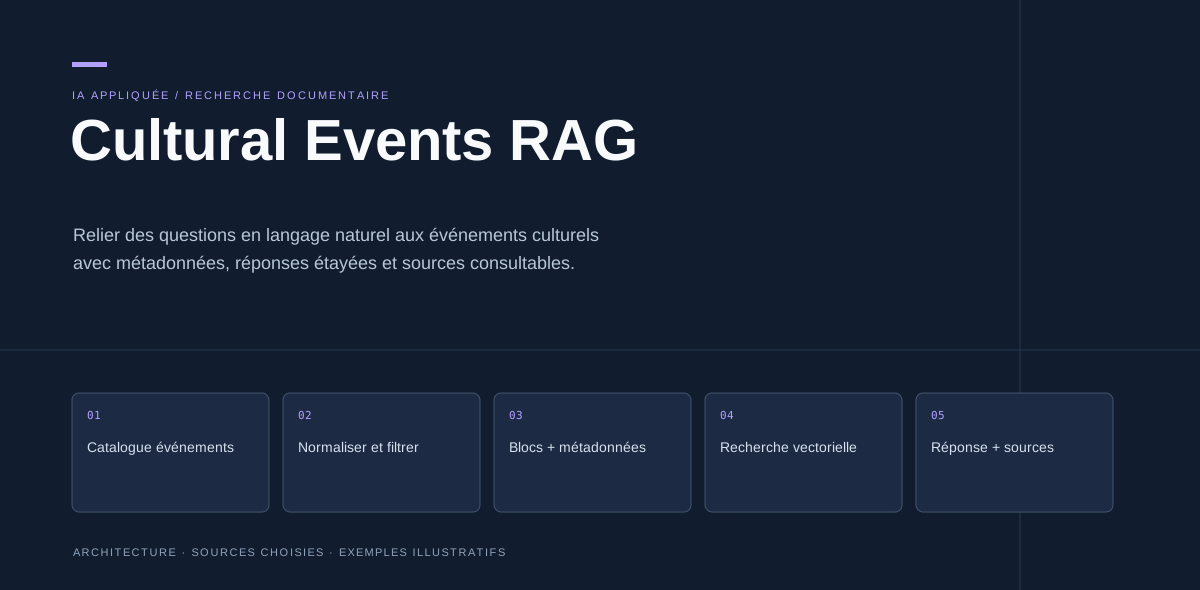
Conception de la recherche d’événements culturels : un catalogue normalisé devient des fragments enrichis de métadonnées pour la recherche vectorielle et des réponses fondées sur les sources.

Architecture illustrative issue de la présentation du projet. Elle décrit la conception sélectionnée ; elle ne constitue ni un service déployé ni un résultat opérationnel mesuré.

Afficher le schéma en grand
  1. Catalogue d’événements

  2. Normalisation et filtrage

  3. Fragments avec métadonnées

  4. Recherche vectorielle

  5. Réponse et sources

04 / Sources présentées

Ce que contient le dépôt.

  • scripts/fetch_events.py
  • scripts/preprocess_events.py
  • scripts/build_vector_store.py
  • scripts/rag.py
  • scripts/evaluate_rag.py
  • scripts/benchmark_pipeline.py
  • docs/retrieval-design.md
  • docs/evaluation.md

05 / Périmètre et limites

Comment lire ce projet.

Démonstration et présentation du code sans assistant hébergé, catalogue prêt à l’emploi, identifiants de fournisseurs, index FAISS sérialisés ni résultats historiques d’évaluation. La configuration retenue utilise une ville d’exemple. La préférence de dates peut compléter les résultats avec des événements hors de la période demandée ; ce n’est pas un filtre strict. La mémoire conversationnelle et la recherche sur plusieurs villes sont hors périmètre. Aucune précision, latence, disponibilité ou réussite des tests n’est revendiquée.
Explorer les sources avec un accès.

Le dépôt GitHub est privé. Son lien fonctionne pour les collaborateurs autorisés ; les autres visiteurs peuvent me contacter pour discuter du projet.

Étude de cas suivante / 10

RAG Platform Architecture

Systèmes de recherche augmentée

Explorer la collection

La prochaine conversation

Parlons de votre projet.

↗
Un besoin, une idée, une question technique.
LinkedIn ↗GitHub ↗